Non partire dal database vettoriale
Molti assistenti AI interni partono dagli embedding per abitudine. Provate prima la ricerca classica su domande reali e aggiungete i vettori solo dove un set di valutazione ne mostra il bisogno.
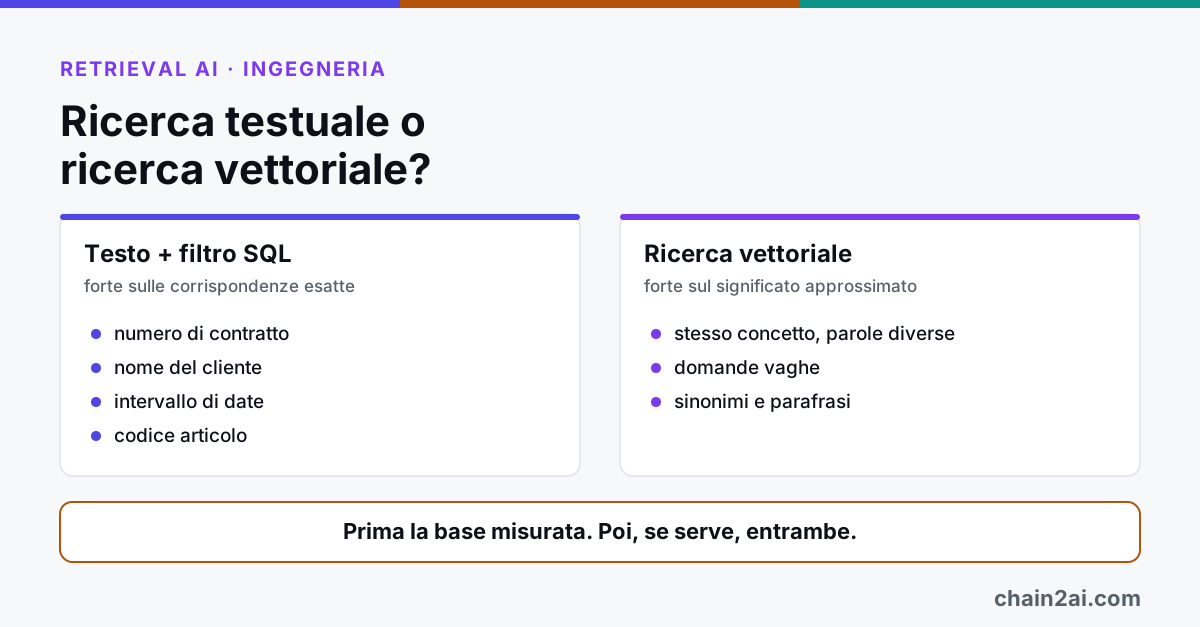
Quando un team costruisce un assistente interno che risponde a domande sui documenti aziendali, lo schema di architettura arriva spesso con un database vettoriale già disegnato. È il default dei tutorial. Raramente è il risultato di una misura. Il risultato è un sistema in più da gestire prima che qualcuno abbia mostrato che la ricerca già disponibile non basta.
Guardate le domande che le persone fanno
Raccogliete domande reali da chi userà l'assistente, non inventate. Ordinatele. Una quota grande è di solito ricerca puntuale: un numero di contratto, il nome di un cliente, un intervallo di date, un codice articolo, una persona. La ricerca vettoriale confronta il significato in modo approssimato, ed è proprio per questo che è debole sulle corrispondenze esatte. La ricerca per parole chiave e un filtro SQL sono l'opposto: precisi sugli identificativi, scarsi quando la domanda usa parole diverse dal documento. Entrambi sono già nel vostro stack.
Costruite prima la base di confronto
Scrivete com'è una risposta corretta per un insieme di una cinquantina di domande. Provatele con la ricerca full-text e con i filtri strutturati, e annotate quante tornano giuste. Quel risultato è la base di confronto, ed è ciò che ogni aggiunta successiva deve battere. Senza, aggiungere i vettori non si può chiamare un miglioramento. Si può chiamare solo un cambiamento.
Aggiungete i vettori dove la base fallisce
Gli embedding si guadagnano il posto quando il problema è il vocabolario: l'utente chiede come chiudere un affitto in anticipo e il documento parla di recesso anticipato dalla locazione. Quando il set di valutazione mostra quella classe di errori, la ricerca ibrida è giustificata: parole chiave più vettori, risultati uniti. A quel punto il guadagno si misura e si decide se vale quanto costa.
Il costo di un archivio in più
Un indice vettoriale è una copia dei vostri documenti. Va tenuto allineato alla fonte, ricostruito quando cambia il modello di embedding, e deve far rispettare gli stessi diritti di accesso del sistema che copia. Chi non può aprire un documento nell'applicazione originale non deve poterlo recuperare tramite l'assistente. Gli errori di permessi in una copia sono silenziosi e difficili da trovare, e quando ci sono dati personali sono anche un problema di conformità.
Niente di tutto questo è un argomento contro la ricerca vettoriale. È un argomento sull'ordine del lavoro. Un team con una base misurata può dire cosa hanno aggiunto gli embedding. Un team senza può dire solo che l'assistente adesso sembra migliore. Quando arriva la versione successiva del modello o dell'indice, il primo team rilancia il set di domande e sa se conviene cambiare.
Partite dalla ricerca noiosa, misuratela, e lasciate che siano gli errori a dirvi cosa aggiungere.
Quali domande del vostro assistente sono ricerche puntuali travestite?