Ne počinjite s vektorskom bazom
Mnogi interni AI asistenti kreću od embeddinga iz navike. Prvo isprobajte klasičnu pretragu na stvarnim pitanjima, a vektore dodajte samo tamo gdje ih eval set pokaže potrebnima.
Kad tim gradi interni asistent koji odgovara na pitanja iz dokumenata tvrtke, arhitektonska shema često stigne s već nacrtanom vektorskom bazom. To je default tutoriala. Rijetko je rezultat mjerenja. Posljedica je još jedan sustav za održavanje prije nego itko pokaže da pretraga koju već imate nije dovoljna.
Pogledajte pitanja koja ljudi postavljaju
Prikupite stvarna pitanja od ljudi koji će koristiti asistenta, a ne izmišljena. Razvrstajte ih. Velik dio obično su lookup pitanja: broj ugovora, ime klijenta, raspon datuma, šifra artikla, osoba. Vector search uspoređuje značenje približno, i upravo zato je slab kod točnih podudaranja. Pretraga po ključnim riječima i SQL filter su suprotni: precizni na identifikatorima, slabi kad pitanje koristi drugačije riječi od dokumenta. Oboje je već u vašem stacku.
Prvo izgradite baseline
Zapišite kako izgleda točan odgovor za skup od pedesetak pitanja. Provedite ih kroz full-text pretragu i strukturirane filtere i zabilježite koliko ih se vrati točno. Taj rezultat je baseline i sve što se kasnije doda mora ga nadmašiti. Bez njega dodavanje vektora ne možete nazvati poboljšanjem. Možete ga nazvati samo promjenom.
Vektore dodajte tamo gdje baseline zakaže
Embeddinzi zaslužuju svoje mjesto kad je problem rječnik: korisnik pita kako prije roka prekinuti najam, a dokument govori o prijevremenom raskidu zakupa. Kad eval set pokaže tu klasu pogrešaka, hybrid retrieval je opravdan: ključne riječi plus vektori, rezultati spojeni. Tada se dobitak može izmjeriti i odlučiti vrijedi li onoliko koliko košta.
Cijena još jednog storea
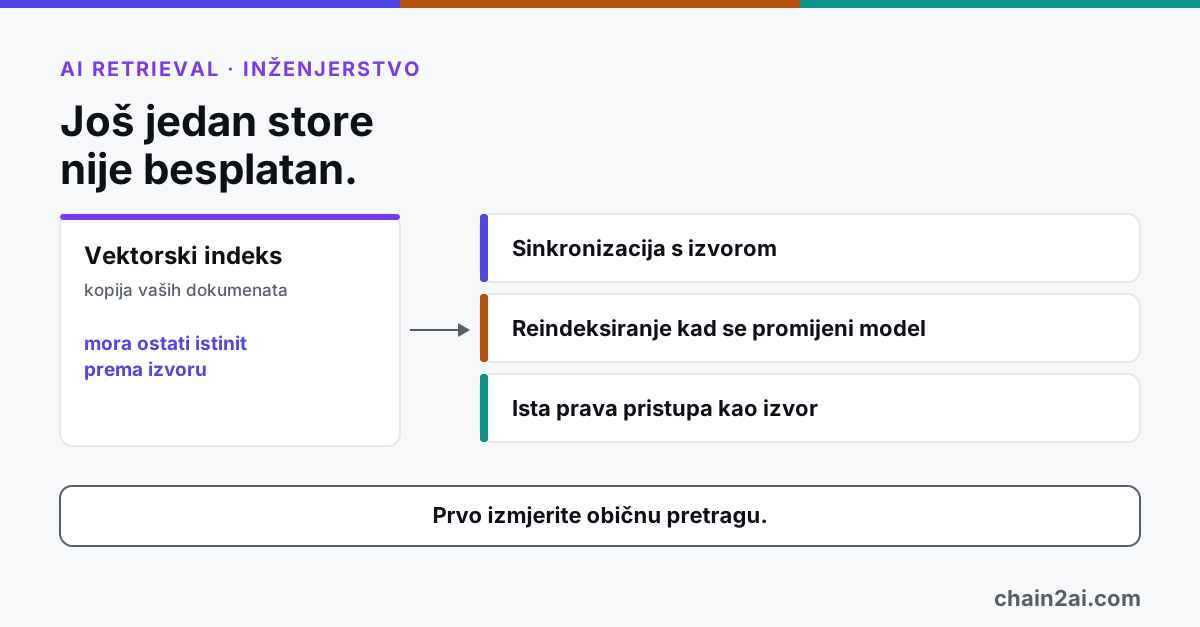
Vektorski indeks je kopija vaših dokumenata. Mora ostati usklađen s izvorom, ponovno se graditi kad se promijeni embedding model i provoditi ista prava pristupa kao sustav koji kopira. Tko ne može otvoriti dokument u originalnoj aplikaciji, ne smije ga moći dohvatiti ni preko asistenta. Greške u pravima na kopiji su tihe i teško se nalaze, a kad su u pitanju osobni podaci, to je i problem usklađenosti.
Ništa od ovoga nije argument protiv vektorske pretrage. To je argument o redoslijedu posla. Tim s izmjerenim baselineom može reći što su embeddinzi dodali. Tim bez njega može reći samo da asistent sada djeluje bolje. Kad stigne sljedeća verzija modela ili indeksa, prvi tim ponovno pokrene skup pitanja i zna isplati li se prijeći. Embeddinzi su koristan alat, samo ne prvi.
Krenite od dosadne pretrage, izmjerite je i pustite da vam pogreške kažu što dodati.
Koja su pitanja u vašem asistentu zapravo lookupi u prerušavanju?